Google DeepMind 在 2026 年 11 月 18 日丟出的這顆 Gemini 4 Neon,講白了根本是拿「中階價位」的皮,塞進了一顆連自家頂規老大哥都要流冷汗的怪物核心。
先講最反直覺的重點:Neon 定位明明夾在頂規旗艦 Carbon 與高速日常版 Hydrogen 中間,價格比 Carbon 便宜四分之一(每百萬輸入 3 美元、輸出 15 美元),結果在 Artificial Analysis 綜合智慧指數拿了 61 分,硬生生反超老大哥 Carbon 的 60 分! 而且速度快上一大截、開放給 Google AI Pro 一般付費訂戶就能用(不用像 Carbon 非得直上 Ultra),搭上 Google Antigravity 後在真實軟體工程測試裡甚至甩開競品將近四倍。
家族內戰先看懂:Neon、Carbon、Hydrogen 差在哪?
Google 這次在官方部落格裡乾脆攤牌畫了一張「Gemini 4 家族戰力對照表」,看完瞬間明白為什麼開發者社群會集體沸騰:
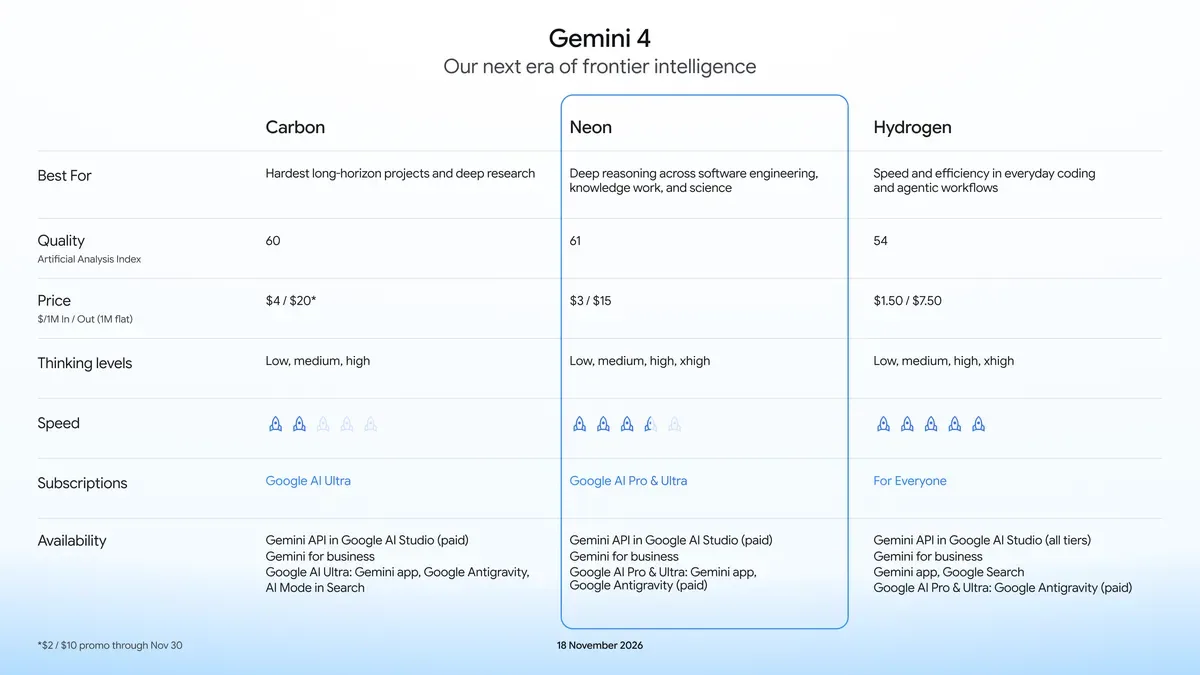
* Gemini 4 Carbon(老大哥):專攻超長週期深度研究,AA 智慧指數 60 分、定價每百萬 4 美元/20 美元(11 月底前促銷 2 美元/10 美元),僅支援 Low/Medium/High 三檔思考,速度偏慢,且訂閱方案限定高價的 Google AI Ultra。
* Gemini 4 Neon(這次主角):主打軟體工程、知識工作與科學深度推理,AA 智慧指數衝上 61 分、定價 3 美元/15 美元(Context Caching 更是直接打 0.5 折砍到 0.15 美元),給滿 Low/Medium/High/Xhigh 四段思考深度與 100 萬 Token 脈絡視窗,速度明顯快上一截,重點是 Google AI Pro 與 Ultra 訂戶、AI Studio 付費 API、Gemini App 與 Google Antigravity 全部開放。
* Gemini 4 Hydrogen(快槍俠):AA 智慧指數 54 分、1.50 美元/7.50 美元、全體免費與一般用戶可用,專門負責超高速日常執行,也常被 Neon 當成底下的平行子代理(Subagent)使喚。
簡單說,以前你要頂級腦袋就得忍受烏龜吐字跟天價帳單,現在 Neon 直接把「夠快、夠聰明、夠省」三個願望塞進同一顆模型裡。
跑分屠榜有多扯?100 萬長文檢索 95.2%、SWE-sweep 甩開對手快四倍
攤開 Google 公布的完整基準測試表,Neon 最可怕的地方不是只贏一兩項偏科考試,而是從寫程式、長上下文、多模態影片理解到資安攻防幾乎全面開花:
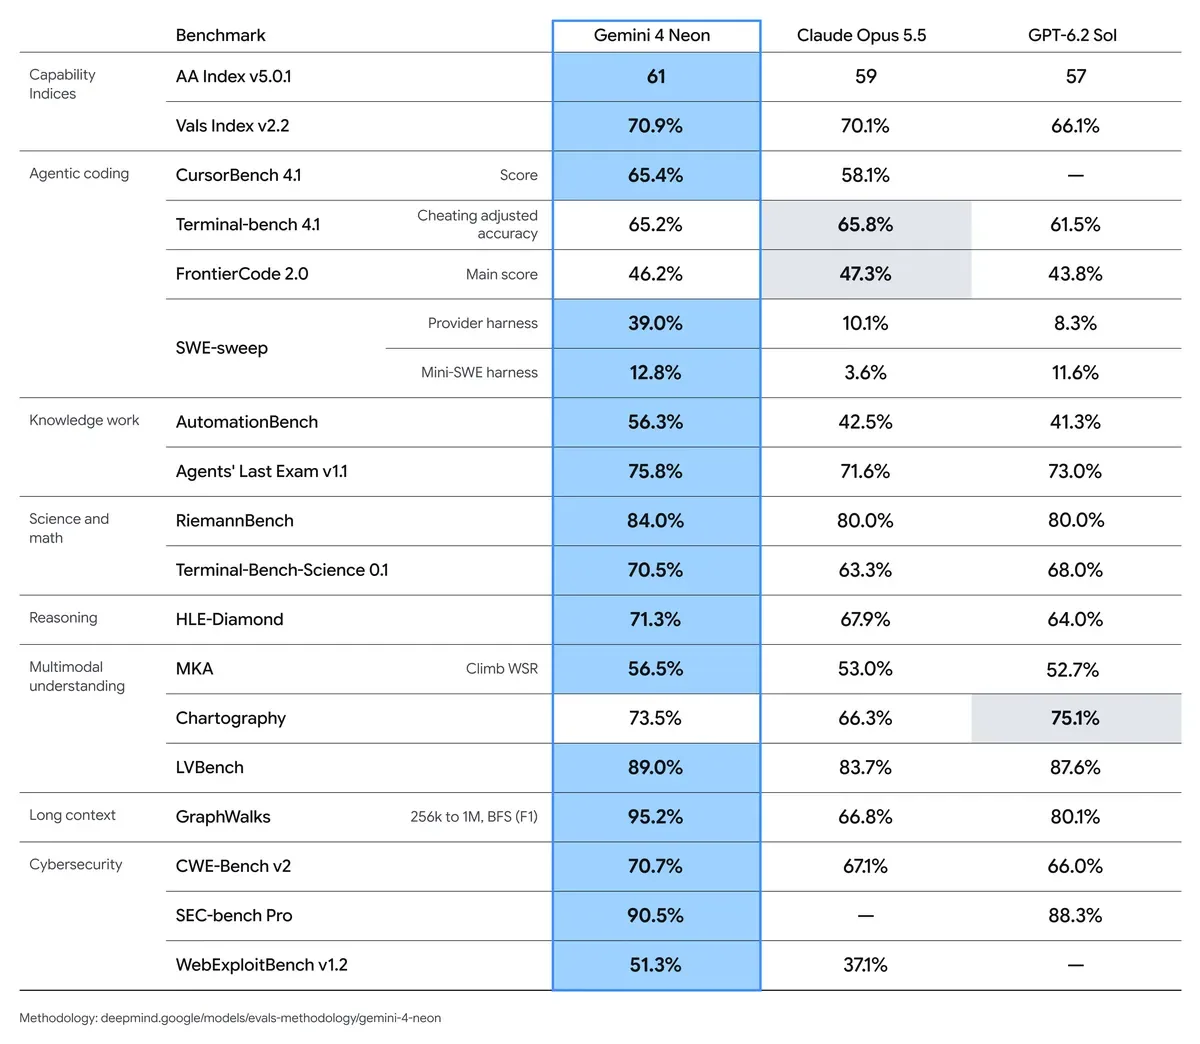
幾個看一眼就讓人倒抽一口氣的數字直接幫你劃重點:
1. 軟體工程與 Agent 代理:接上 Antigravity 直接解鎖三倍戰力
* Artificial Analysis Coding Agent Index 全球第一(58.6),CursorBench 4.1 拿下 65.4%(大幅領先 Claude Opus 5.5 的 58.1%),Terminal-Bench 4.1 也有 65.2%、FrontierCode 2.0 預設 high 檔即達 46.2%。
* 最扯的是 SWE-sweep(大型程式碼庫跨檔除錯與修補):在基礎 mini-SWE 框架下 Neon 以 12.8% 領先(Opus 5.5 為 3.6%),一旦換上 Google Antigravity 專屬執行框架,分數直接暴衝超過三倍來到 SOTA 39.0%——對比 Claude Opus 5.5(10.1%)與 GPT-6.2 Sol(8.3%)幾乎拉開四倍差距。
* 實務上最討喜的進化,是它不只會自己單幹,還能當高判斷力的「總指揮(Orchestrator)」去調度底下好幾個平行的 Hydrogen 子代理同時幹活,大幅減少重複讀檔跟長對話失憶問題。
2. 百萬脈絡不是寫好看的:GraphWalks 飆出 95.2%
很多模型雖然號稱支援超長脈絡,但真的塞進幾十萬字後就開始「大海撈針全忘光」。Neon 在專門考驗 256k 到 1M Token 超長距離圖譜推理 的 GraphWalks 測試裡直接轟出 95.2%(對照 Claude Opus 5.5 的 66.8% 與 GPT-6.2 Sol 的 80.1%),在長影片理解 LVBench 也拿到 89.0%。丟整份大型專案、幾百頁財報 PDF、試算表加錄音檔進去一次問,它真的記得住細節。
3. 商務、科學與自動化全能王
* Vals Index 全球第二(70.9%),直接拿下法律研究(Legal Research Bench)與稅務代理(Tax Agent Bench)雙料第一。
* Zapier AutomationBench 全球第一(56.3%)、模擬長線開公司賺錢的 Vending-Bench 2 全球第一(進帳 16,843 美元)。
* 科學數學方面,RiemannBench 衝到 84.0%、HLE-Diamond 71.3%、Terminal-Bench Science 70.5%。
* 全球超過 4,200 場真實代理對戰的 Agent Arena Index 首發就空降全球第二(1336 分),更猛的是「中途可糾正度(Steerability)」同樣排全球第二——寫到一半你突然喊卡改需求,它不會像舊模型一樣卡死或鬼打牆。
成本曲線才是真正大殺器:省 50%~80% 照樣跑在最前排
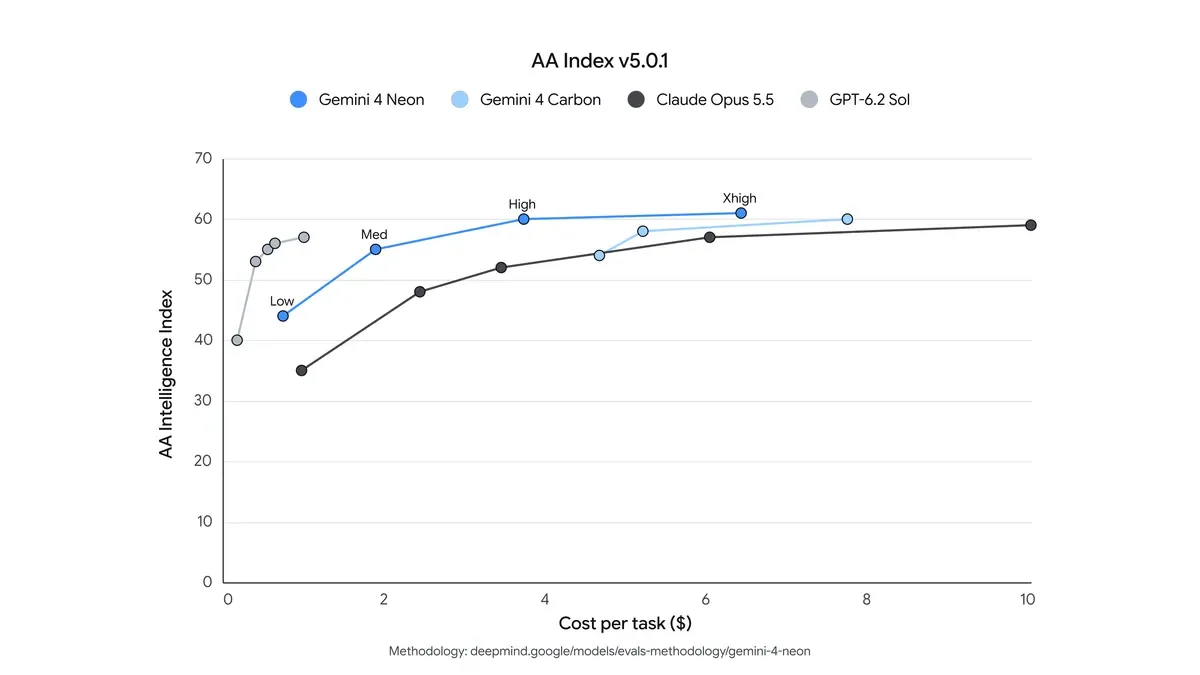
這張成本對照圖大概是開發者最愛的一張。Neon 的 Low → Med → High → Xhigh 四段思考深度切得非常線性:
* 開在預設 High 檔,每完成一項任務的成本比自家 Carbon 省 32%,跟其他頂規競品相比更是直接 省下 50% 到 80%。
* 就算咬牙把思考切到滿血 Xhigh 檔硬幹最難的工程與科研任務,拿到最高 61 分智慧指數的同時,單任務花費依舊比競品最高檔 便宜超過 36%。
官方實測四大狂人級 Antigravity 展示:連 Excel 都能拿來跑 3D 打光?
光看跑分可能還是有點抽象,Google 直接丟出四個用 Google Antigravity 跑 Gemini 4 Neon 實做出來的怪物級展示,完全展現這顆模型有多不講理:
1. 零素材手刻 WebGL2 自由式滑雪模擬器:直接抓真實白朗峰與霞慕尼海拔地形資料,從零寫出 10,200 行自訂 Shader、120 Hz 物理運算、六條高山路線、動態雪道刻痕、板狀雪崩與空間 Web Audio 音效,完全沒套現成素材包。
2. 用 50 萬條試算表公式把圖片變 3D 打光引擎:透過 Agent Swarm 把一張單圖轉成 10 萬格 Google Sheet——零內嵌圖片、零 Apps Script,純靠超過 50 萬條即時試算表公式 算出邊緣偵測、3D 深度圖跟六種互動打光模式,簡直在挑戰人類對試算表的認知極限。
3. 重現圖靈 1936 年劍橋書房互動 3D:自己去查歷史檔案照片,透過 /swarm 還原出劍橋國王學院 Room X.8 與室外禮拜堂,連書桌上那台通用圖靈機都能直接點開來跑。
4. 驅動 Blender MCP 打造元素實驗室:自動操作 Blender 建出寫實 3D 實驗桌,還精準對應元素化學特性——用本生燈火焰代表 Carbon/Hydrogen,用高壓氣體放電管點亮 Argon 與 Neon。
資安攻防順便封神,還大幅根治 AI「愛偷懶跟瞎掰」的老毛病
這波還藏了兩個企業與重度用戶會超有感的升級:
* 資安攻防三連殺:安全寫碼測試 AutoBaxBench 困難題拿 76%(SOTA)、滲透測試 WebExploitBench v1.2 拿 51.3%(成本只要競品一半)、漏洞挖掘 SEC-bench Pro 高達 90.5%、根因修補 CWE-Bench v2 達 70.7%(比 Carbon 還多 3.4%)。在 Gray Swan 間接提示詞注入(IPI)防護測試裡,開最高思考等級更是繳出 0.0% 攻擊成功率 的滿分防禦。
* 少偷懶、少瞎掰、也不亂拒答:用過 AI 寫程式的人最恨它偷偷寫假資料矇混過關。Neon 在 Terminal-Bench 4.0 作弊率壓到 0.0%,程式偷吃步評測降到全家族最低的 2.45%,誠實度評測高達 99.2%;相比 Carbon,敷衍漏做(under-service)再減 43%~56%、擅自亂改越權(overreach)再降 15%~35%,而且不會過度敏感亂拒絕正常工作(Terminal-Bench-Science 拒答率 0%)。
玩報編輯部短評:一般人與開發者現在怎麼玩到它?
如果你本身已經有訂閱 Google AI Pro 或 Ultra,現在直接打開 Gemini App 或 Google Antigravity 就能選用 Gemini 4 Neon;開發者也可以直接在 Google AI Studio 開啟付費 API 實測。
老實說,AI 戰場打到 2026 年底,能跑高分已經不稀奇,真正讓開發者願意把整個工作流搬過去的,是像 Gemini 4 Neon 這樣「給出頂規大腦、收你中階房租、還不給你偷工減料」的狠角色。唯一要擔心的,大概是這顆模型太順手,一不小心就讓整個團隊全部跳槽過去了。
你已經在 Gemini App 或 Antigravity 裡開到 Gemini 4 Neon 了嗎?實測起來速度跟寫碼體感有沒有讓你驚豔,還是拿它去跑什麼神奇任務,歡迎來留言區曬戰果!